
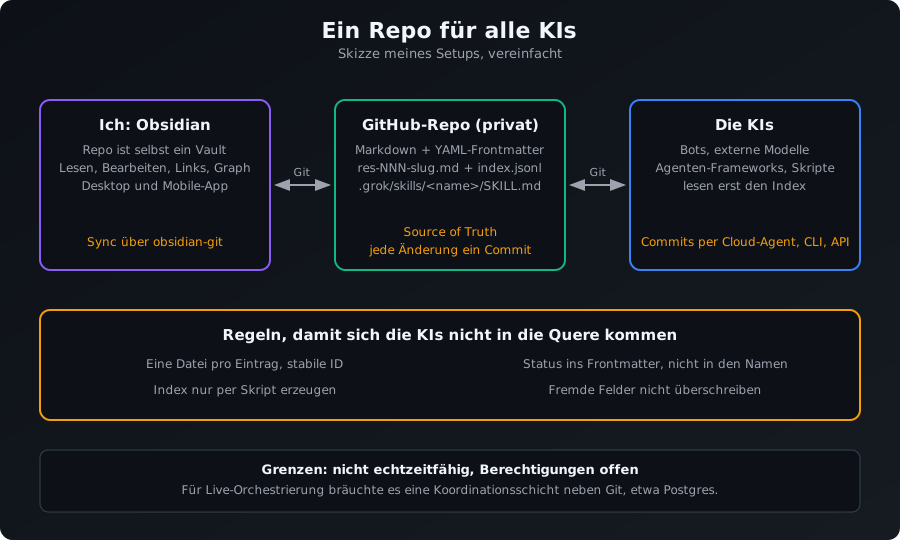
Ein Repo für alle KIs: Mein Multi-AI-Harness mit Obsidian und GitHub
Wie ich ein privates GitHub-Repo mit Markdown-Dateien zur gemeinsamen Ablage für mehrere KIs mache, Obsidian als meine Oberfläche darauf nutze und welche Regeln nötig wurden, als mehrere Bots in dieselben Dateien schrieben.
Bernd D.H. Martin
Ich arbeite inzwischen mit mehreren KIs parallel: Bots, die für mich recherchieren und Inhalte entwerfen, externe Modelle, Agenten-Frameworks und ein paar Skripte. Die Frage war, wo das gemeinsame Wissen liegt, auf das alle zugreifen. Meine Antwort ist unspektakulär: in einem privaten GitHub-Repo voller Markdown-Dateien. Obsidian ist die Oberfläche, mit der ich selbst darauf schaue.
Dieses Lab beschreibt ein laufendes Setup, es ist kein Messbericht. Zahlen zu Commits pro Bot oder Konflikten pro Woche habe ich noch nicht erhoben. Was unten steht, sind Beobachtungen und Entscheidungen aus dem Alltag und ein Plan, wie ich das Ganze messen will.
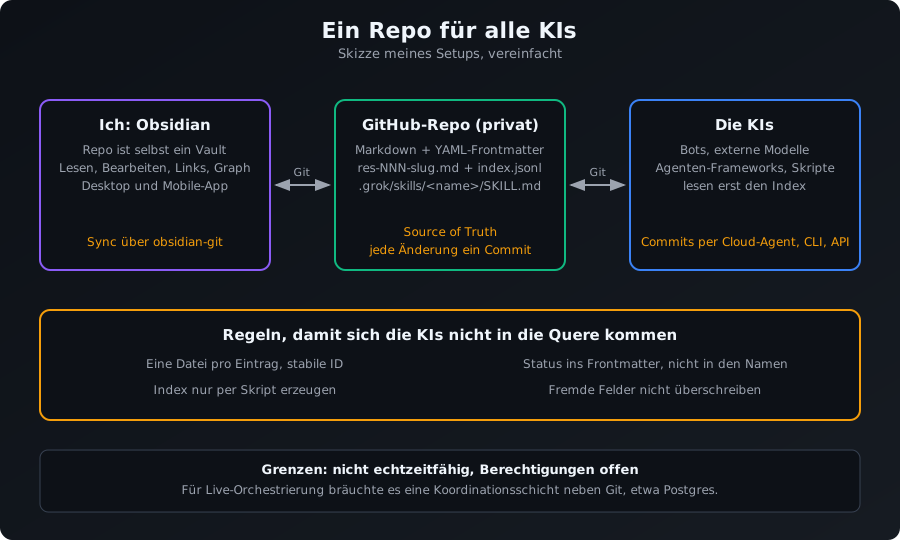
Der Aufbau
- Source of Truth: ein privates GitHub-Repo mit Markdown-Dateien und YAML-Frontmatter.
- Meine Oberfläche: Obsidian. Das Repo ist selbst ein Obsidian-Vault. Dort lese und bearbeite ich, nutze Links, den Graph und die Mobile-App. Das Plugin obsidian-git holt die Änderungen der KIs und schreibt meine zurück.
- Sync: Basis ist Git. In Obsidian erledigt das obsidian-git, auf anderen Geräten Obsidian Sync oder Git.
- Die KIs: Bots und Agenten schreiben über Git-Commits, je nach Werkzeug per Cloud-Agent, CLI oder API.
- Agenten-Definitionen: Skills und Regeln liegen als Markdown im selben Repo, bei mir unter
.grok/skills/<name>/SKILL.md. Weitere Tools können eigene Ordner bekommen, etwa.claude/. - Einstieg für Maschinen: Index-Dateien im JSONL-Format, die ein Skript aus dem Frontmatter erzeugt. Ein Agent liest zuerst den Index und öffnet dann nur die Dateien, die er wirklich braucht.
Ein Beispiel ist mein AI-Research-Backlog. Jeder Eintrag ist eine eigene Datei nach dem Muster res-NNN-short-slug.md, daneben liegt eine index.jsonl. Auch dieser Artikel ist aus so einem Eintrag entstanden (res-034).
Warum Markdown und Git
- Markdown kann jede KI und jeder Mensch lesen und schreiben. Ich binde mich damit an keinen Anbieter.
- Git bringt Versionierung, History, Diff und Rollback mit. Jede Änderung einer KI ist ein Commit mit Autor und Message, also nachvollziehbar und umkehrbar.
- Agenten-Definitionen, Memory und Inhalte liegen am selben Ort.
- Ich brauche keine Spezialplattform, die Kosten liegen nahe null.
Was nicht funktioniert hat und welche Regeln daraus wurden
Das Backlog war anfangs eine große Sammeldatei. Sobald mehrere Bots darin arbeiteten, gab es Merge-Konflikte, und Felder wie der Status wurden überschrieben. Am 13.11.2026 habe ich das Backlog deshalb auf Einzeldateien umgestellt. Daraus sind ein paar Regeln entstanden:
- Eine Datei pro Eintrag, stabile ID im Dateinamen. Das senkt das Risiko von Merge-Konflikten gegenüber einer großen Sammeldatei deutlich. Dateien und IDs werden nicht umbenannt.
- Status und Metadaten gehören ins Frontmatter, nicht in den Dateinamen oder in die Ordnerstruktur. Sonst wird jeder Statuswechsel zu einer Umbenennung und erzeugt neue Konflikte.
- Der Index entsteht nur per Skript, nie von Hand. Wer einen Eintrag ändert, baut den Index neu und committet beides zusammen.
- Fremde Felder werden nicht überschrieben. Sobald mehrere Bots dieselben Dateien pflegen, ist diese Regel nötig. Den Status „übergeben“ setze zum Beispiel nur ich.
- Wird ein Push abgelehnt, gilt
pull --rebasestatt Überschreiben.
Wo das Setup an Grenzen stößt
- Nicht echtzeitfähig: Commit, Push und Pull bringen Verzögerung mit. Für hochparallele Live-Orchestrierung taugt Git nicht. Dafür bräuchte es eine eigene Koordinationsschicht daneben, etwa eine Datenbank wie Postgres.
- Ohne Konventionen wird es Wildwuchs: Namens-, Frontmatter- und Ordnerregeln müssen feststehen, bevor mehrere KIs loslegen.
- Berechtigungen: Jeder Bot mit Schreibzugriff kann alles ändern. Bei meiner Website arbeiten die Bots über Branch und Pull Request, gemergt wird von mir. Ob ich das für das Wissens-Repo genauso mache oder nur bestimmte Ordner schütze, habe ich noch nicht entschieden.
Eine mögliche Struktur
So könnte ein Repo für mehrere KIs aussehen. Das ist ein Beispiel und in meinem Repo noch nicht so umgesetzt:
/agents/          # Agenten-Definitionen, Rollen, Skills (oder .grok/skills/, .claude/ …)
/memory/          # geteiltes Wissen, Fakten, Entscheidungen
/inbox/           # Eingang: Rohnotizen, Aufgaben von Mensch an KI
/logs/            # Lauf-Protokolle der Agenten (append-only)
/templates/       # Vorlagen für Einträge
/docs/<backlog>/  # Einzeldateien prefix-NNN-slug.md + index.jsonl
current-tasks.md  # aktuelle Aufgaben
rules.md          # verbindliche Regeln für alle KIs
Jede Datei bekommt YAML-Frontmatter mit mindestens id, title, date, status und tags.
So will ich es messen
Zwei oder drei verschiedene KIs sollen eine Woche lang parallel in dasselbe Repo schreiben. Vorher erhebe ich eine einfache Commit-Statistik pro Bot als Ausgangsbasis.
| Kriterium | Wie ich es messe | Stand |
|---|---|---|
| Merge-Konflikte | Anzahl pro Woche, mit und ohne Konventionen | offen |
| Fehler | überschriebene Felder, kaputtes Frontmatter | offen |
| Manueller Aufwand | Zeit fürs Aufräumen, vorher und nachher mit Regeln und Index-Skript | offen |
| Aktivität | Commits pro Bot | noch nicht erhoben |
Offene Fragen
- Wie gehe ich mit Konflikten im Index um, wenn zwei Bots gleichzeitig committen?
- Sollen Agenten im Wissens-Repo direkt auf main pushen oder über Branch und Pull Request mit Review?
- Gehört das Memory der Bots ins Repo, und wenn ja, nur Fakten oder auch Verläufe?
- Wie verhindere ich, dass Zugangsdaten oder private Daten im Repo landen?
Nächste Schritte
- Eine
rules.mdmit den geltenden Regeln für alle KIs im Repo-Root anlegen. - Die Skill-Definitionen an die tatsächliche Struktur angleichen (Pflichtfelder, Index-Felder, Pfade).
- Die Commit-Statistik pro Bot als Basis für die Messung erheben.
- Entscheiden, ob es beim direkten Push auf main bleibt oder ausgewählte Ordner einen Branch-Schutz bekommen.
Verwandte Themen auf bmline: Letta Code und ein Memory-Dateisystem auf Git-Basis und der Harness-Prozess.
Zwei Gartensäulen in Eigenregie: Wie Gemini bei Mischung und Nachbehandlung half
Ich habe zwei Säulen für die Einfahrt selbst entworfen und vergossen. Gemini half bei Mengen, Mischreihenfolge und Nachbehandlung; Gewichtsschätzung und ein paar Annahmen musste ich vor Ort korrigieren.
Der Harness-Prozess: Warum 2026 das Jahr der kontrollierten KI-Autonomie ist
Was ein Agentic Harness ist, wie er funktioniert, und warum er der entscheidende Unterschied zwischen einem Spielzeug und einem echten KI-Entwicklungspartner ist.